


MT, NMT und LLM in der Übersetzung: Unterschiede 2026
Was ist der Unterschied zwischen MT, NMT und LLM?
Der Kern des Unterschieds liegt in der Architektur und dem Kontextverständnis. Regelbasierte maschinelle Übersetzung (MT) arbeitet mit fest codierten Grammatikregeln und Wörterbüchern. Neuronale maschinelle Übersetzung (NMT) lernt aus parallelen Satzpaaren und übersetzt statistisch wahrscheinlich. Große Sprachmodelle (LLM) hingegen werden zunächst auf riesigen monolingualen Textmengen vortrainiert und verstehen Sprache auf einer grundlegend anderen Ebene.
Für Entscheidungsträger in Übersetzung und Lokalisierung bedeutet das konkret:
MT (regelbasiert): Wörtliche Ausgabe, schwaches Kontextverständnis, hohes Fehlerrisiko bei Fachtexten und sicherheitskritischen Inhalten.
NMT (neuronales Netz): Deterministisch, schnell und kosteneffizient bei großen Volumen. Konsistente Ausgabe bei identischen Eingaben, aber schwach bei dokumentübergreifendem Kontext und Terminologiesteuerung ohne zusätzliche Unternehmenskontrollen.
LLM (Transformer-basiert): Verarbeitet ganze Dokumente, folgt komplexen Anweisungen, passt Ton und Register an. Dafür teurer, langsamer und anfällig für Halluzinationen bei regulierten Inhalten.
Kosten und Geschwindigkeit: NMT ist deutlich günstiger und schneller bei Massenübersetzungen. LLMs liefern bei kontextabhängigen Texten höhere Qualität, benötigen aber mehr Rechenressourcen.
Fachübersetzung: Für regulierte Dokumente in Medizin, Recht oder Technik reicht weder Standard-NMT noch ein öffentliches LLM allein. Hier braucht es einen geprüften Hybridansatz.
Profi-Tipp: Wer ChatGPT übersetzen lässt, ohne Terminologievorgaben und Qualitätssicherung einzubinden, riskiert bei Fachtexten unkontrollierte Abweichungen. Für regulierte Inhalte ist das keine Option.
Technische Grundlagen: Wie unterscheiden sich Architektur und Training?
Regelbasierte MT: Der älteste Ansatz
Klassische maschinelle Übersetzung folgt explizit programmierten Grammatikregeln und zweisprachigen Wörterbüchern. Das System übersetzt Wort für Wort nach festgelegten Mustern. Flexibilität fehlt vollständig. Idiome, Mehrdeutigkeiten oder domänenspezifische Terminologie führen regelmäßig zu Fehlern, die für Fachpersonen sofort erkennbar sind.
NMT: Neuronale Netze auf Satzebene
NMT-Systeme basieren auf Encoder-Decoder-Architekturen, die auf Millionen paralleler Satzpaare trainiert werden. Das Modell lernt statistische Muster zwischen Ausgangs- und Zielsprache. Entscheidend: NMT übersetzt Satz für Satz, ohne den Dokumentkontext zu kennen. Ein Pronomen wie „es“ im Deutschen, das auf ein zuvor genanntes feminines Substantiv verweist, kann ein NMT-System ohne diesen Kontext falsch auflösen.
Der Vorteil liegt im Determinismus. Dieselbe Eingabe ergibt immer dieselbe Ausgabe. Für Workflows, die Konsistenz über Tausende von Segmenten erfordern, ist das ein echter Pluspunkt.
LLM: Vortraining auf monolingualen Daten
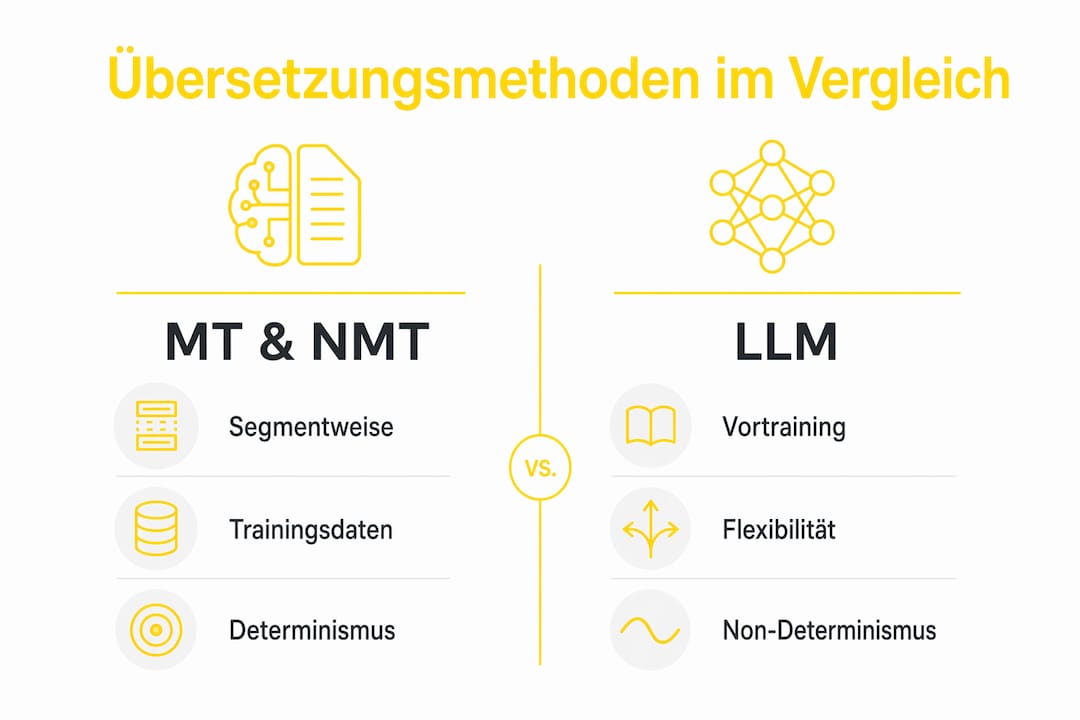
LLMs lernen zunächst, das nächste Wort in einem Text vorherzusagen. Dieses Vortraining auf enormen mehrsprachigen Datensätzen gibt ihnen ein tiefes Sprachverständnis. Erst danach folgt eine Feinabstimmung für spezifische Aufgaben wie Übersetzung. LLMs passen sich in Echtzeit über Techniken wie In-Context Learning und Retrieval Augmented Generation an Terminologie und Stil an, ohne neu trainiert werden zu müssen.
Das ist der fundamentale Unterschied zu NMT: Anstatt eines monatelangen Trainingsprozesses lässt sich die Anpassung in Millisekunden erreichen.
Merkmal | MT (regelbasiert) | NMT | LLM |
Architektur | Regelbasiert, Wörterbuch | Encoder-Decoder, neuronales Netz | Transformer, Vortraining auf monolingualen Daten |
Trainingsdaten | Grammatikregeln, Lexika | Parallele Satzpaare | Monolinguale Massendaten, Feinabstimmung |
Kontextfenster | Wort/Phrase | Satz | Ganzes Dokument |
Ausgabe | Deterministisch, wörtlich | Deterministisch | Generativ, variabel |
Evaluationsmetriken | BLEU | BLEU, COMET | COMET, BERTScore, menschliche Bewertung |
Geschwindigkeit | Sehr schnell | Schnell | Langsamer |
Kosten | Niedrig | Niedrig bis mittel | Höher |
Zur Qualitätsmessung: Automatische Metriken wie BLEU bevorzugen NMT-Ausgaben, weil sie näher an den Referenzübersetzungen liegen. Menschliche Bewerter vergeben LLMs deutlich höhere Werte, sobald diese mit Kontext oder Beispielen versorgt werden. COMET und BERTScore korrelieren besser mit menschlichem Urteil als BLEU.
Kontextverständnis, Terminologie und Qualitätssicherung im Vergleich
Satzebene gegen Dokumentebene
NMT übersetzt segmentweise. Jeder Satz ist für das Modell eine eigenständige Einheit. Das führt zu Inkonsistenzen: Ein Begriff kann im ersten Absatz anders übersetzt werden als im dritten. Für technische Dokumentation, Verträge oder Beipackzettel ist das ein ernstes Problem.
LLMs verarbeiten ganze Dokumente und halten Terminologie, Register und Erzählstil über den gesamten Text konsistent. Dafür bringen sie ein bekanntes Risiko mit: Halluzinationen. Das Modell kann Begriffe oder Formulierungen erzeugen, die im Ausgangstext nicht vorhanden sind. Bei regulierten Inhalten wie Medizinprodukten oder Rechtstexten ist das ein erhebliches Risiko.
Terminologiesteuerung: Wo NMT und LLM an Grenzen stoßen
Standard-NMT-Systeme lassen sich mit Terminologiedatenbanken erweitern, aber die Durchsetzung bleibt begrenzt. Öffentliche LLMs wie ChatGPT können zwar Terminologievorgaben in einem Prompt entgegennehmen, garantieren deren konsequente Anwendung aber nicht. Wer ChatGPT übersetzen lässt und dabei auf konsistente Fachterminologie angewiesen ist, wird das schnell merken.
Proprietäre LLM-Systeme mit eingebetteter Terminologiesteuerung lösen dieses Problem strukturell, nicht durch Prompting allein.
Kriterium | MT | NMT | Proprietäres LLM (z. B. AD VERBUM) |
Kontextsensitivität | Keine | Satzebene | Dokumentebene |
Terminologiedurchsetzung | Wörterbuch | Begrenzt | Strukturell eingebettet |
Halluzinationsrisiko | Niedrig | Niedrig | Vorhanden, durch SME-Prüfung kontrolliert |
Datenhoheit | Variabel | Variabel | EU-gehostet, DSGVO-konform |
Regulatorische Eignung | Gering | Bedingt | Hoch (mit Qualitätssicherung) |
ISO-konforme Workflows | Nein | Bedingt | Ja (ISO 17100, ISO 18587) |
Das Non-Determinismus-Problem bei LLMs
Wiederholte Übersetzungen desselben Textes durch ein LLM können leicht voneinander abweichen. Für ISO-konforme Workflows, die Reproduzierbarkeit erfordern, ist das eine echte Herausforderung. NMT liefert bei identischer Eingabe immer dieselbe Ausgabe. Dieser Determinismus ist kein Luxus, sondern eine Voraussetzung für auditierbare Übersetzungsprozesse in regulierten Branchen.
Profi-Tipp: Für Dokumente, die unter MDR, HIPAA oder ähnlichen Regelwerken stehen, reicht weder Standard-NMT noch ein öffentliches LLM. Entscheidend ist ein Workflow, der Terminologiedurchsetzung, menschliche Fachprüfung und ISO-konforme Qualitätssicherung verbindet.
Wann eignen sich MT, NMT und LLM jeweils am besten?
Die Technologiewahl hängt von Inhaltstyp, Volumen, Qualitätsanforderungen und Compliance-Kontext ab. Hier sind die wichtigsten Szenarien:
1. Kreative und Marketinginhalte
LLMs sind hier klar überlegen. Sie passen Ton, Stil und kulturelle Referenzen an, statt wörtlich zu übersetzen. Ein Werbeslogan, der im Deutschen funktioniert, entsteht durch Transkreation, nicht durch Wort-für-Wort-Übertragung. NMT liefert hier oft steife, unnatürliche Ergebnisse.
2. Technische und rechtliche Fachdokumentation
Für Verträge, Beipackzettel, Normen und technische Handbücher gilt: Terminologiepräzision schlägt Sprachfluss. Spezialisierte NMT-Systeme mit Terminologiedatenbanken haben hier traditionell gut abgeschnitten. Proprietäre LLM-Systeme mit eingebetteter Terminologiesteuerung und menschlicher Fachprüfung liefern heute die verlässlichere Kombination aus Kontextverständnis und Genauigkeit.
3. Echtzeitübersetzung und Live-Kommunikation
NMT ist die einzige praktische Wahl. Die Latenz von LLMs liegt je nach Modell bei mehreren Sekunden pro Absatz. NMT-Systeme antworten in unter 200 Millisekunden. Für Live-Chat, Kundenservice oder Untertitelung ist das entscheidend.
4. Mehrsprachige Projekte mit seltenen Sprachpaaren
LLMs erzielen bessere Ergebnisse bei seltenen Sprachen, weil sie auf großen mehrsprachigen Datensätzen vortrainiert wurden und weniger auf parallele Korpora angewiesen sind. NMT-Systeme brauchen ausreichend parallele Trainingsdaten. Fehlen diese, leidet die Qualität spürbar.
5. Massenübersetzung bei hohem Volumen
Bei Millionen von Wörtern pro Monat ist NMT wirtschaftlich kaum zu schlagen. Die Kosten pro Zeichen liegen deutlich unter denen von LLM-Schnittstellen. Für Produktbeschreibungen, Nutzerbewertungen oder Wissensdatenbankeinträge ist NMT oft die sinnvollste Wahl, sofern keine hohen Qualitätsanforderungen bestehen.
6. Maschinelle Übersetzung mit anschließender Nachbearbeitung (MTPE)
Das Nachbearbeiten maschineller Übersetzungen durch Fachübersetzer ist ein etablierter Workflow. MTPE nach ISO 18587 kombiniert die Geschwindigkeit von NMT mit menschlicher Qualitätssicherung. Für viele regulierte Branchen ist das der pragmatische Mittelweg, solange die Ausgangsqualität der maschinellen Übersetzung hoch genug ist.
7. Regulierte Inhalte mit Audit-Anforderungen
Weder Standard-NMT noch öffentliche LLMs erfüllen hier die Anforderungen allein. Auditierbare Prozesse erfordern nachvollziehbare Terminologiedurchsetzung, dokumentierte Qualitätssicherung und Datenhoheit. Das ist der Bereich, in dem ein strukturierter AI+HUMAN hybrid translation-Ansatz mit ISO-Zertifizierung unverzichtbar wird.
8. Datenschutzkritische Übersetzungen
Wer sensible Daten aus dem Bereich Life Sciences, Verteidigung oder Finanzwesen übersetzt, darf diese nicht über öffentliche Cloud-Dienste leiten. EU-gehostete, DSGVO-konforme Infrastruktur ist Pflicht. Öffentliche LLM-Dienste scheiden hier aus, weil unklar bleibt, wie Eingabedaten weiterverarbeitet werden.
Wie AD VERBUM die Grenzen von MT, NMT und LLM überwindet
AD VERBUM hat mit dem proprietären LangOps System einen Ansatz entwickelt, der die strukturellen Schwächen aller drei Technologiegenerationen adressiert. Das System ist kein öffentliches LLM und kein Standard-NMT. Es ist eine KI-gestützte Übersetzungslösung mit eingebetteter Terminologiesteuerung, EU-gehosteter Infrastruktur und vollständiger menschlicher Fachprüfung.
Der AI+HUMAN hybrid translation Workflow folgt einer festen Sequenz:
Asset-Integration: Kundeneigene Translation Memories und Terminologiedatenbanken werden zuerst eingelesen und binden das System an die etablierte Unternehmenssprache.
LLM-Generierung: Das proprietäre LLM-basierte System erzeugt die Zielsprachausgabe, strikt begrenzt durch die Terminologievorgaben und Stilrichtlinien des Kunden.
Fachprüfung: Zertifizierte Fachübersetzer aus einem Netzwerk von über 3.500 Experten, darunter Mediziner, Juristen und Ingenieure, prüfen auf technische Korrektheit, regulatorische Konformität und kontextuelle Stimmigkeit.
Qualitätssicherung: Der QA-Prozess ist an ISO 17100 und ISO 18587 ausgerichtet und berücksichtigt sektorspezifische Anforderungen wie die Medizinprodukteverordnung.
Was AD VERBUM von Standard-Lösungen unterscheidet, ist die Kombination aus proprietärer Technologie und struktureller Compliance. Das LangOps System läuft auf privaten EU-Servern, ohne Abhängigkeit von öffentlichen Cloud-Diensten für die Kernverarbeitung. Das erfüllt DSGVO-Anforderungen nicht nur auf dem Papier, sondern in der Infrastruktur selbst.
Die Rolle von LLMs bei Compliance-Übersetzungen ist bei AD VERBUM klar definiert: Das Modell generiert, der Fachmensch prüft und verantwortet. Kein öffentliches LLM, kein Standard-NMT-System bietet diese Kombination aus Terminologiedurchsetzung, Datenhoheit und auditierter Qualitätssicherung.
AD VERBUM unterstützt über 150 Sprachen einschließlich regionaler Varianten und liefert laut eigenen Angaben Übersetzungen 3x bis 5x schneller als klassische Übersetzungsworkflows. Das ist kein Widerspruch zur Qualität, sondern das Ergebnis eines Prozesses, der KI-Generierung und menschliche Prüfung nicht nacheinander, sondern strukturell verzahnt.
Für Entscheidungsträger in regulierten Branchen, die weder auf ChatGPT übersetzen noch auf langsame klassische Workflows setzen wollen, ist das der entscheidende Unterschied.
Wer professionelle Fachübersetzungen mit nachweisbarer Compliance benötigt, findet bei AD VERBUM einen Ansatz, der technologisch auf LLM-Niveau arbeitet und gleichzeitig die Governance-Anforderungen regulierter Branchen erfüllt.
Wichtige Erkenntnisse
MT, NMT und LLM unterscheiden sich grundlegend in Architektur, Kontextverarbeitung und regulatorischer Eignung. Für Fachübersetzungen in regulierten Branchen ist keiner der drei Ansätze allein ausreichend.
Thema | Details |
MT vs. NMT vs. LLM | MT ist regelbasiert und wörtlich, NMT deterministisch und satzbasiert, LLM kontextsensitiv und generativ. |
Terminologiesteuerung | Standard-NMT und öffentliche LLMs garantieren keine konsistente Terminologiedurchsetzung bei Fachtexten. |
Halluzinationsrisiko | LLMs können Inhalte erfinden, die im Ausgangstext fehlen. Für regulierte Dokumente ist menschliche Prüfung Pflicht. |
Regulierte Inhalte | Auditierbare Workflows erfordern ISO-konforme Qualitätssicherung, Datenhoheit und Fachprüfung. |
AD VERBUM LangOps System | Proprietäres LLM mit AI+HUMAN hybrid translation, EU-gehostet, nach ISO 17100, 18587 und 27001 zertifiziert. |
Empfehlung


