


LLM-basierte Sprachintelligenz: Was steckt dahinter?
LLM-basierte Sprachintelligenz bezeichnet den Einsatz großer Sprachmodelle (Large Language Models) in Kombination mit Terminologie-Governance und domänenspezifischen Sprachassets für präzise, kontextsensitive Sprachverarbeitung. Für Entscheider in regulierten Branchen sind drei Parameter sofort relevant: Wo werden die Daten verarbeitet (EU-Hosting), wie wird Terminologie erzwungen (Terminologie-Governance via Translation Memories und Term Bases), und wer prüft die Ausgabe (zertifizierter AI+HUMAN-Workflow).
Kurzübersicht für Entscheider:
Sofort handeln: Wenn Sie regulierte Dokumente (MDR, GDPR, HIPAA) übersetzen lassen und noch keinen Anbieter mit EU-Hosting und ISO-Nachweis haben.
Prüfen: Ob Ihr aktueller Anbieter TM/TB-Integration, SME-Review und Audit-Logs nachweisen kann.
Vermeiden: Übersetzungen via ChatGPT übersetzen oder vergleichbare Consumer-Tools für regulierte Inhalte. Kein Audit-Trail, kein Terminologie-Schutz, kein GDPR-konformes Hosting.
Inhaltsverzeichnis
Wie funktionieren LLMs technisch bei der Sprachverarbeitung?
Legacy-MT, NMT und LLM-Sprachintelligenz: Was ist der Unterschied?
Welche Compliance-Anforderungen gelten für regulierte Branchen?
Wie wählen Sie den richtigen Anbieter für LLM-Sprachintelligenz aus?
Wie sieht ein geprüfter AI+HUMAN-Workflow in der Praxis aus?
Warum verantwortungsvoller LLM-Einsatz mehr als Technologie ist
Wie funktionieren LLMs technisch bei der Sprachverarbeitung?
Große Sprachmodelle basieren auf der Transformer-Architektur mit Self-Attention-Mechanismus. Das bedeutet konkret: Das Modell verarbeitet nicht Wort für Wort sequenziell, sondern betrachtet den gesamten Eingabetext gleichzeitig und gewichtet Beziehungen zwischen Wörtern und Phrasen dynamisch.
Der Prozess läuft in mehreren Schritten ab:
Tokenisierung: Text wird in Subwort-Einheiten (Tokens) zerlegt.
Einbettungen (Embeddings): Tokens werden als mehrdimensionale Vektoren dargestellt, sodass semantisch ähnliche Begriffe im Vektorraum nah beieinander liegen.
Attention-Gewichtung: Der Self-Attention-Mechanismus bestimmt, welche Tokens für die Vorhersage des nächsten Tokens besonders relevant sind.
Dekodierung: Das Modell generiert die Ausgabe Token für Token, gesteuert durch Dekodierungsstrategien wie Beam Search oder Sampling.
Für die Fachübersetzung entscheidend ist die Kontextspanne: Moderne LLMs verarbeiten lange Dokumente und halten terminologische Konsistenz über Abschnitte hinweg aufrecht. Legacy-MT-Systeme scheitern hier regelmäßig, weil sie Satz für Satz ohne Dokumentgedächtnis arbeiten.
Profi-Tipp: Achten Sie bei der Anbieterauswahl darauf, ob das Modell durch Instruction Tuning oder domänenspezifisches Fine-Tuning auf Ihre Fachterminologie angepasst wurde. Ein generisches LLM ohne diese Anpassung produziert plausibel klingende, aber terminologisch inkonsistente Ausgaben.
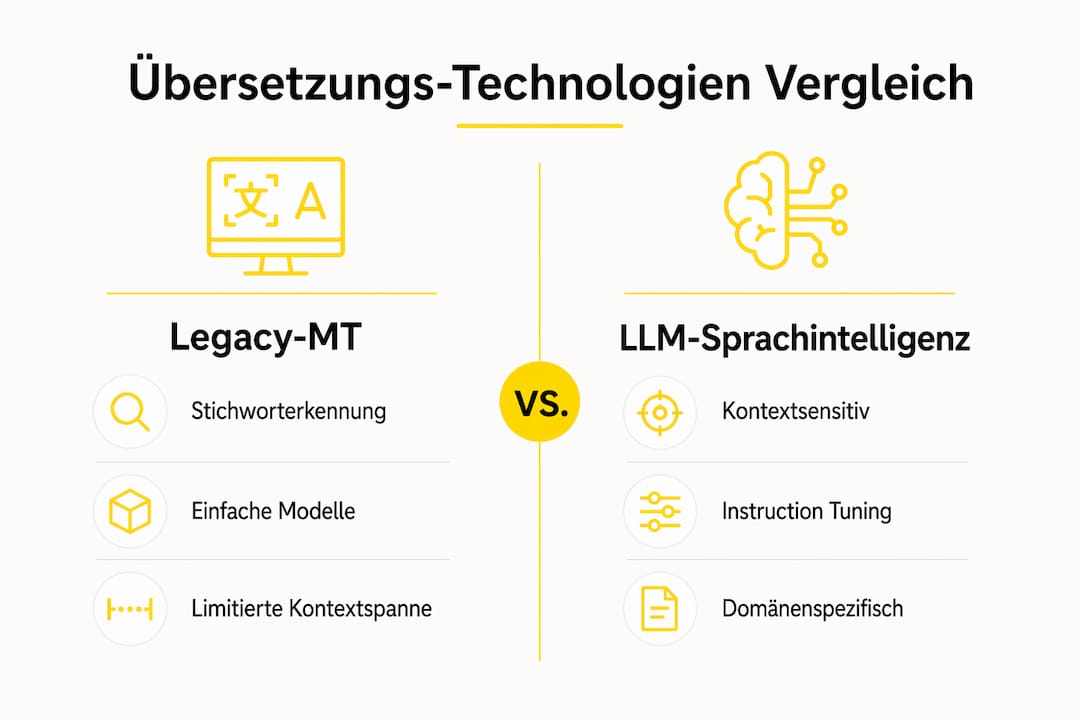
Legacy-MT, NMT und LLM-Sprachintelligenz: Was ist der Unterschied?
Der Unterschied liegt nicht nur in der Technologie, sondern in den Konsequenzen für regulierte Inhalte.
Legacy-MT (regelbasiert/statistisch): Wörtliche Ausgabe, kein Kontextverständnis. Für Gebrauchsanweisungen oder Zulassungsdossiers schlicht ungeeignet.
NMT (Neuronale maschinelle Übersetzung): Deutlich flüssiger, aber mit inkonsistenter Terminologiekontrolle. Negationen und Domänennuancen werden variabel behandelt. Öffentliche NMT-Dienste bieten keine Governance für regulierte Dokumentation.
LLM-basierte KI-Übersetzung: Kontextsensitiv über das gesamte Dokument, mit expliziter Terminologieerzwingung via TM/TB-Integration und nachweisbarer Governance.
Vergleichskriterien im Überblick:
Kontexttiefe: Legacy-MT: Satzebene. NMT: begrenzt. LLM: Dokumentebene.
TM/TB-Integration: Legacy-MT: keine. NMT: selten. LLM (professionell): zwingend.
Auditierbarkeit: Nur professionelle LLM-Systeme mit dedizierter Infrastruktur bieten Audit-Logs.
Hosting/Datenschutz: Consumer-NMT: öffentliche Cloud. Professionelle LLM-Lösung: EU-Server.
SME-Review: Nur im AI+HUMAN-Workflow standardmäßig integriert.
Wer regulierte Dokumente mit ChatGPT übersetzen lässt, riskiert Datenabfluss, fehlende Auditierbarkeit und terminologische Fehler, die in einem MDR-Dossier oder einem Finanzprospekt direkte Haftungsfolgen haben können. Consumer-Tools sind für interne Entwürfe tolerierbar. Für alles, was in eine Zulassung, einen Vertrag oder eine Gebrauchsanweisung einfließt, sind sie keine Option.
Weitere Hintergründe zu den Risiken öffentlicher Übersetzungsplattformen finden Sie in einer gesonderten Analyse.
Welche Compliance-Anforderungen gelten für regulierte Branchen?
Compliance-Anforderungen stehen über Feature-Versprechen. EU-Hosting und Audit-Trails sind keine Optionen, sondern Voraussetzungen.
Konkrete Anforderungen, die Entscheider prüfen müssen:
GDPR: Personenbezogene Daten dürfen nicht auf Servern außerhalb der EU verarbeitet werden. Jeder Übersetzungsauftrag mit Patientendaten, Vertragsdaten oder Mitarbeiterdaten fällt darunter.
MDR (Medical Device Regulation): Gebrauchsanweisungen und Kennzeichnungen müssen terminologisch exakt und nachvollziehbar übersetzt sein. Versionskontrolle ist Pflicht.
HIPAA: Für Unternehmen mit US-Geschäft gelten zusätzliche Anforderungen an den Schutz von Gesundheitsdaten.
Audit-Trails: Regulatoren erwarten Nachvollziehbarkeit. Welche Quelle, welches Modell, welcher Prüfer hat welche Version freigegeben?
Versionskontrolle: Änderungen müssen dokumentiert und rückverfolgbar sein.
Zertifikate als verlässliche Prüfsignale: ISO 27001 (Informationssicherheit), ISO 17100 (Übersetzungsdienstleistungen), ISO 18587 (Post-Editing maschineller Übersetzung), ISO 13485 (Medizinprodukte), ISO 42001 (KI-Governance), ISO 9001 (Qualitätsmanagement) und AQAP2110 für Verteidigungsprojekte. Unabhängige Auditierung durch eine akkreditierte Stelle wie Bureau Veritas ist dabei aussagekräftiger als Selbstauskunft.
Compliance-Warnung: Öffentliche KI-Plattformen ohne dediziertes EU-Hosting können Eingabedaten für Modelltraining verwenden. Für regulierte Inhalte ist das ein inakzeptables Risiko.
Wie wählen Sie den richtigen Anbieter für LLM-Sprachintelligenz aus?
Fünf Fragen, die Sie jedem Anbieter stellen sollten, bevor Sie einen Auftrag vergeben:
Wo werden meine Daten verarbeitet und gespeichert? (EU-Server oder nicht?)
Wie werden meine Translation Memories und Term Bases in den LLM-Prozess integriert?
Welche Zertifikate liegen vor, und wer hat sie unabhängig auditiert?
Wie ist der SME-Review-Prozess strukturiert, und welche Qualifikationen haben die Prüfer?
Welche SLA gilt für Fehlerkorrektur, und wie sehen Audit-Reports aus?
Red Flags, die Sie zur Ablehnung veranlassen sollten:
Kein EU-Hosting oder keine klare Antwort auf die Hosting-Frage.
Fehlende ISO-Nachweise oder nur Selbstauskunft ohne unabhängige Auditierung.
Keine SME-Review im Workflow, nur automatisierte Ausgabe.
Generische NMT-Angaben ohne Erklärung der Terminologie-Governance.
Kein Audit-Log-Angebot für regulierte Dokumente.
Verlangen Sie als Nachweis: eine Musterübersetzung mit Terminologie-Konformitätsbericht, Zertifikatskopien mit Gültigkeitsdatum, und eine Beschreibung des Fine-Tuning- oder Instruction-Tuning-Prozesses für Ihre Domäne. Wer das nicht liefern kann, ist für regulierte Inhalte nicht geeignet. Mehr dazu, warum Fachübersetzer im KI-Zeitalter unverzichtbar bleiben, lesen Sie in einer weiterführenden Analyse.
Wie sieht ein geprüfter AI+HUMAN-Workflow in der Praxis aus?
AD VERBUM verbindet LLM-Generierung mit zertifizierter SME-Prüfung und ISO-konformer QA. Der Ablauf ist auditierbar und für regulierte Branchen ausgelegt.
Asset-Integration: Kundenseitige Translation Memories ™ und Term Bases (TB) werden zuerst eingespeist. Das LLM arbeitet von Beginn an innerhalb der genehmigten Terminologie.
LLM-Generierung: Das proprietäre LangOps-System erzeugt die Zielsprachausgabe, gebunden an Terminologie- und Stilanforderungen des Kunden.
SME-Fachprüfung: Ein zertifizierter Fachexperte aus dem Netzwerk von über 3.500 Spezialisten prüft auf technische Korrektheit, regulatorische Konformität und kontextuelle Nuancen.
ISO-konforme QA: Qualitätssicherung nach ISO 17100 und ISO 18587, bei Medizinprodukten zusätzlich MDR-konform. Ergebnis: freigegebene Übersetzung mit Audit-Log.
Vertrauenssignale von AD VERBUM:
EU-Hosting auf privater Infrastruktur, keine Abhängigkeit von öffentlichen Cloud-Diensten für die Kernverarbeitung.
Unabhängige Auditierung durch Bureau Veritas.
Zertifikate: ISO 9001, ISO 17100, ISO 18587, ISO 13485, ISO 27001, ISO 42001, AQAP2110.
Liefergeschwindigkeit: 3x bis 5x schneller als traditionelle Übersetzungsabläufe (AD VERBUM-Angabe).
Ein konkretes Beispiel: Eine medizinische Gebrauchsanweisung mit 50 Seiten wird mit der kundenseitigen TB abgeglichen, LLM-generiert, von einem approbierten Mediziner geprüft und mit vollständigem Änderungsprotokoll freigegeben. Das Ergebnis ist MDR-konform und für Zulassungsbehörden nachvollziehbar.
Wie der AI+HUMAN-Ansatz in der Praxis funktioniert, zeigt eine detaillierte Prozessbeschreibung.
Wann bringt LLM-basierte KI-Übersetzung echten Mehrwert?
Nicht jeder Text braucht ein LLM-System mit vollem Governance-Stack. Aber in diesen Szenarien ist er zwingend:
Medizintechnik: IFUs, Zulassungsdossiers, Kennzeichnungen. Hohe Terminologiedichte, MDR-Pflicht, Versionskontrolle erforderlich. Traditionelle NMT reicht nicht.
Recht: Verträge, Due-Diligence-Berichte, Schiedsunterlagen. Jede Abweichung in der Terminologie kann Haftungsfolgen haben. SME-Review durch Juristen ist Pflicht.
Finanzen: Prospekte, Jahresberichte, regulatorische Meldungen. Konsistenz über das gesamte Dokument und Audit-Trail für Aufsichtsbehörden sind nicht verhandelbar.
Verteidigung: Technische Dokumentation, NATO-Beschaffungsunterlagen. AQAP2110-Konformität und Geheimhaltungsanforderungen machen EU-Hosting zur Grundvoraussetzung.
Wann reicht eine einfachere Lösung? Für interne Kommunikation ohne regulatorische Relevanz, für Marketingtexte ohne Compliance-Bezug oder für Entwürfe, die noch keine Freigabe benötigen, kann NMT mit manueller Nachbearbeitung ausreichend sein. Sobald ein Dokument in eine Zulassung, einen Vertrag oder eine Gebrauchsanweisung einfließt, gelten andere Maßstäbe. Praktische KI-Übersetzungsbeispiele aus dem Compliance-Bereich zeigen, wo der Unterschied in der Praxis sichtbar wird.
Wichtige Erkenntnisse
LLM-basierte Sprachintelligenz liefert für regulierte Branchen nur dann verlässliche Ergebnisse, wenn Terminologie-Governance, EU-Hosting und zertifizierte SME-Prüfung fest im Workflow verankert sind.
Thema | Details |
Definition LLM-Sprachintelligenz | LLMs plus Terminologie-Governance plus domänenspezifische Assets ergeben kontextsensitive, auditierbare Sprachverarbeitung. |
Compliance-Voraussetzungen | EU-Hosting, Audit-Trails und ISO-Zertifikate (z. B. ISO 27001, ISO 17100) sind für regulierte Branchen nicht optional. |
Consumer-Tools meiden | ChatGPT übersetzen und vergleichbare Dienste bieten keinen Audit-Trail, keine Terminologiekontrolle und kein GDPR-konformes Hosting. |
Beschaffungskriterien | TM/TB-Integration, SME-Review, unabhängige Auditierung und nachweisbares Fine-Tuning sind die kaufentscheidenden Kriterien. |
AD VERBUM | Bietet AI+HUMAN hybrid translation mit EU-Hosting, Bureau-Veritas-Auditierung und über 3.500 zertifizierten Fachexperten für regulierte Branchen. |
Warum verantwortungsvoller LLM-Einsatz mehr als Technologie ist
Die Debatte um LLM-basierte Sprachintelligenz dreht sich zu oft um Modellgröße und Benchmark-Ergebnisse. Was Entscheider in regulierten Branchen aber wirklich brauchen, ist Kontrolle, nicht Staunen.
Ein LLM ist eine Vorhersagemaschine. Es generiert das wahrscheinlichste nächste Token, nicht das korrekteste. Ohne erzwungene Terminologie, ohne SME-Review und ohne Audit-Log ist das Ergebnis für ein MDR-Dossier oder einen Finanzprospekt schlicht nicht verwendbar. Die Technologie ist beeindruckend. Aber das Modell ist nicht das Produkt. Das Produkt ist der Prozess darum herum.
AD VERBUM hat diesen Prozess über 25 Jahre aufgebaut: ISO-zertifiziert, unabhängig auditiert, mit einem Netzwerk von über 3.500 Fachexperten aus Medizin, Recht, Technik und Verteidigung. Das LangOps-System ist kein generisches KI-Tool, das man abonniert. Es ist eine auditierbare Infrastruktur, die Entscheider für Zulassungsbehörden, Aufsichtsstellen und interne Compliance-Teams nachweisen können.
Wer einen Anbieter beauftragt, sollte nicht fragen: „Nutzen Sie KI?“ Sondern: „Können Sie mir den Audit-Log der letzten Übersetzung zeigen?“
AD VERBUM: Geprüfte LLM-Lösungen für regulierte Branchen
Wenn Ihr nächstes Projekt ein Zulassungsdossier, einen Vertrag oder eine technische Dokumentation umfasst, die vor Behörden oder Aufsichtsstellen bestehen muss, brauchen Sie mehr als ein KI-Übersetzungstool. Sie brauchen einen nachweisbaren Prozess.
AD VERBUM liefert professionelle Fachübersetzung mit AI+HUMAN hybrid translation: EU-gehostet, Bureau-Veritas-auditiert, ISO-zertifiziert und 3x bis 5x schneller als traditionelle Abläufe. Über 150 Sprachen, Fachexperten aus Ihrem Sektor, vollständige TM/TB-Integration und Audit-Logs, die Sie Ihren Behörden vorlegen können.
Für ein Angebot benötigen wir: Dateitypen und Volumen, Zielsprachen, gewünschtes Service-Level (Standard oder MDR/AQAP-konform) und Ihre Compliance-Anforderungen. Den vollständigen Überblick über alle Dienstleistungen finden Sie direkt auf der Website. Nehmen Sie Kontakt auf und fordern Sie ein Proof-of-Concept an.
Quellen und weiterführende Referenzen
Für Entscheider empfiehlt sich folgende Lesereihenfolge: zuerst die technischen Grundlagen, dann die regulatorischen Standards, dann die Beschaffungsdokumente.
Was ist LLM? Große Sprachmodelle erklärt (AWS) — Einstieg in Transformer-Architektur, Embeddings und Anwendungsfelder; geeignet für technische Tiefe.
LLM-Grundlagen (Microsoft Learn) — Vortraining, Instruction Tuning, Fine-Tuning und Agent-Frameworks; relevant für Beschaffungsgespräche.
Wie funktionieren LLMs? (Fraunhofer IESE) — Technische Einordnung mit Fokus auf TM/TB-Integration und Systemarchitektur; nützlich für IT-seitige Due Diligence.
Was sind Large Language Models? (IBM) — Governance-Perspektive: Halluzinationsrisiken, Terminologiekontrolle, Compliance-Überlegungen.
Was sind große Sprachmodelle? (Databricks) — Überblick über Trainingsverfahren und Self-Attention; gut für technische Entscheider.
Large Language Model (Wikipedia DE) — Breiter Überblick; Ausgangspunkt für Begriffsklärungen.
Was sind LLMs? (Microsoft Azure) — Praxisnahe Erklärung mit Fokus auf Unternehmensanwendungen.
ISO 17100, ISO 18587, ISO 27001, ISO 13485, ISO 42001 — Normtexte direkt über iso.org abrufbar; maßgeblich für Beschaffungsanforderungen und Lieferantenaudits.
Dieser Artikel dient der allgemeinen Information. Für verbindliche Compliance-Entscheidungen in Ihrem spezifischen regulatorischen Kontext wenden Sie sich an einen qualifizierten Rechts- oder Compliance-Berater.
Empfehlung


