


Wie funktioniert Textautomatisierung für regulierte Inhalte?
Textautomatisierung ist ein kontrollierter, datengesteuerter Prozess: Strukturierte Unternehmensdaten werden über regelbasierte Vorlagen oder kontextsensitive Sprachmodelle in überprüfbare Fachtexte überführt. Für regulierte Branchen gilt dabei eine klare Bedingung: Nur ein AI+HUMAN hybrid translation-Workflow, der Terminologie-Governance, Fachprüfung und lückenlose Nachvollziehbarkeit verbindet, ist audit-fähig.
Die Kernkomponenten im Überblick:
Strukturierte Eingangsdaten (PIM-Attribute, CSV-Felder, API-Feeds) als notwendige Voraussetzung für reproduzierbare Outputs
Vorlagen oder LLM zur Textgenerierung, konfiguriert durch Fachexperten
Terminologiedatenbank (Translation Memories, Term Bases) zur Durchsetzung verbindlicher Begriffe
SME-Review durch zertifizierte Fachprüfer für technische Richtigkeit und regulatorische Konformität
Audit-Trail mit Versionsprotokollen, Freigabesignaturen und Archivierung
Ohne diese Kontrollebenen ist automatisierte Textgenerierung für Pharma-, Medizintechnik- oder Rechtsdokumente kein gangbarer Weg.
Inhaltsverzeichnis
Was bedeutet Textautomatisierung im Kontext regulierter Inhalte?
Wie läuft eine AI+HUMAN hybrid translation Schritt für Schritt ab?
Welche Vorteile und Risiken bringt Textautomatisierung in regulierten Branchen?
Welche Compliance-Anforderungen und Zertifikate müssen Sie prüfen?
Wie wählen Sie den richtigen Anbieter für Textautomatisierung?
Warum kontrollierte Automatisierung der einzige realistische Weg ist
Was bedeutet Textautomatisierung im Kontext regulierter Inhalte?
Textgenerierung, auch als Natural Language Generation (NLG) bekannt, bezeichnet die automatische Produktion natürlicher Sprache aus strukturierten Daten. Der Kern: Ohne sauber strukturierte Eingangsdaten sind skalierbare, reproduzierbare Textoutputs schlicht nicht möglich.
Drei technische Ansätze prägen die Praxis:
Regelbasiert: Vorlagen mit Platzhaltern, befüllt aus PIM-Exporten oder CSV-Feldern. Zuverlässig für standardisierte Textarten wie Produktbeschreibungen oder Wetterberichte, aber starr bei komplexen Fachkontexten.
NMT-erweiterte Systeme: Neuronale maschinelle Übersetzung verbessert die sprachliche Flüssigkeit, bleibt aber ohne explizite Terminologie-Governance anfällig für fachliche Inkonsistenzen.
Kontextsensitive LLM-Generierung: Sprachmodelle verstehen Dokumentkontext und folgen expliziten Anweisungen, benötigen aber strikte Prompt-Konfiguration und Terminologiezwang durch gepflegte Term Bases und Translation Memories.
Entscheidend für regulierte Inhalte: Vorlagen, Stilvorlagen und Regelsets müssen von Fachexperten erstellt und fortlaufend gepflegt werden. Das Tool allein liefert keine Compliance.
Welche Risiken entstehen bei MT, NMT und Consumer-KI?
Die Wahl der Übersetzungsmethode bestimmt den Governance-Aufwand direkt. Drei Ansätze, drei Risikoprofile:
Klassische maschinelle Übersetzung (MT) liefert wörtliche Outputs mit schwacher Kontextverarbeitung. Bei sicherheitskritischen Texten, etwa Gebrauchsanweisungen für Medizinprodukte, ist die Fehlerwahrscheinlichkeit bei Bedeutungsnuancen hoch.
Neuronale maschinelle Übersetzung (NMT), wie sie in weit verbreiteten SaaS-Übersetzungsdiensten zum Einsatz kommt, erzeugt flüssigere Texte. Aber: Terminologie-Kontrolle, Umgang mit Negationen und Fachdomänen-Nuancen bleiben ohne robuste Enterprise-Steuerung unzuverlässig. NMT ist kein Ersatz für eine echte KI-Übersetzung auf LLM-Basis.
Consumer-KI wie ChatGPT übersetzen zu lassen ist für regulierte Dokumente ausdrücklich nicht empfehlenswert. Halluzinationen, fehlende Terminologie-Durchsetzung und Datenschutzrisiken durch öffentliche Cloud-Infrastruktur machen solche Tools für Pharma-, Medizintechnik- oder Rechtsinhalte ungeeignet.
LLM-basierte Systeme mit expliziter Terminologie-Governance und EU-Hosting sind der einzige Ansatz, der dokumentenweite Kohärenz, Audit-Fähigkeit und Datensouveränität gleichzeitig bietet. Doch auch hier gilt: Ohne SME-Review und ISO-konforme QA bleibt selbst das beste Sprachmodell unvollständig.
Profi-Tipp: Fragen Sie jeden Anbieter konkret nach dokumentierter Terminologie-Durchsetzung (erzwungene Term Bases und Translation Memories) und nach Audit-Protokollen, die Reviewer-Signaturen und Versionsstände nachweisen.
Wie läuft eine AI+HUMAN hybrid translation Schritt für Schritt ab?
Ein audit-fähiger Workflow folgt einer festen Abfolge. Saubere Datenvorbereitung steht dabei immer am Anfang, nicht die Tool-Wahl.
Asset-Integration: Translation Memories, Term Bases, Glossare und Styleguides werden eingelesen. Ausgangsdatenformate (PIM, CSV, API-Feeds) werden geprüft und normiert.
Vorkonfiguration: Prompt-Engineering, Constraint-Sets und Datenschutzregeln werden definiert. Das EU-Hosting wird sichergestellt, Testsets werden vorbereitet.
LLM-Generierung: Das proprietäre Sprachmodell erzeugt Zielsprachentexte unter Terminologiezwang. Jede Version wird protokolliert.
Fachprüfung (SME-Review): Zertifizierte Fachexperten prüfen auf technische Richtigkeit, regulatorische Konformität und kontextuelle Nuancen. Änderungen werden dokumentiert.
ISO-konforme QA: Qualitätssicherung nach ISO 17100 und ISO 18587, ggf. ergänzt durch sektorspezifische Anforderungen wie die EU-Medizinprodukteverordnung (MDR). Freigabeprotokoll und Archivierung für Audits.
Welche Vorteile und Risiken bringt Textautomatisierung in regulierten Branchen?
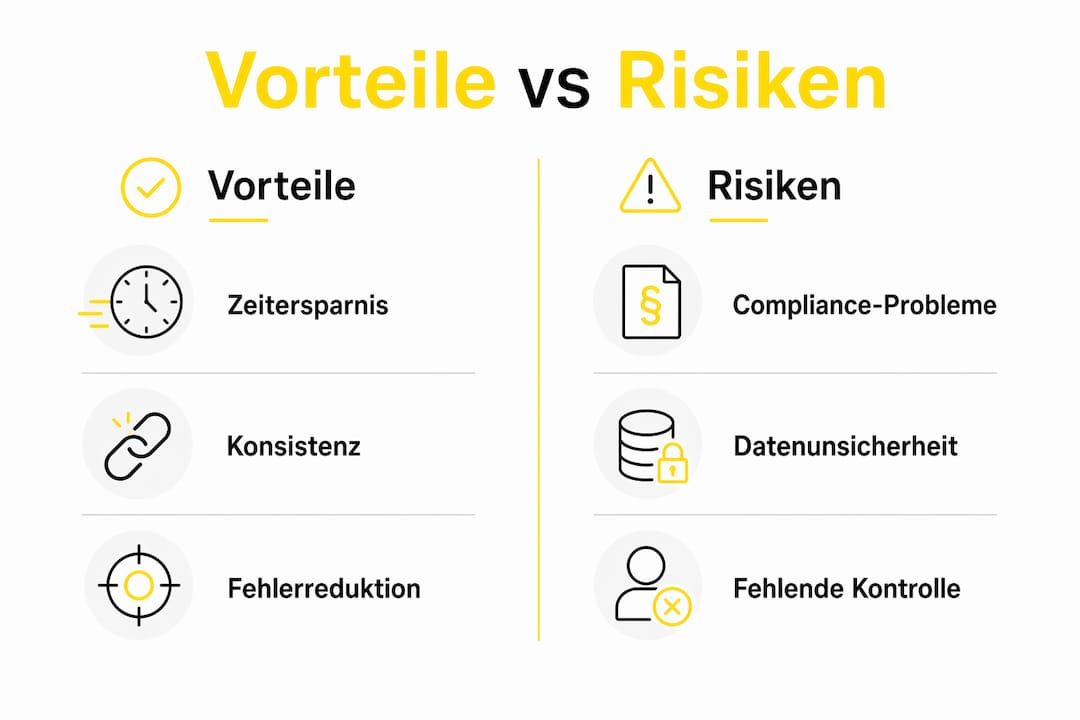
Die Vorteile sind real, aber an Bedingungen geknüpft:
Skalierung: Große Dokumentenmengen in 150+ Sprachen ohne linearen Personalaufwand
Konsistenz: Terminologie-Durchsetzung über alle Dokumente und Sprachversionen hinweg
Aktualisierungsautomatik: Änderungen in Term Bases propagieren sich in Folgeversionen
Mehrsprachige Auffindbarkeit: Konsistente Fachbegriffe verbessern die Sichtbarkeit in mehrsprachigen Märkten
Doch Textautomatisierung ersetzt keine professionelle Qualitätsprüfung. Die typischen Risiken:
Fachliche Ungenauigkeiten bei unzureichend gepflegten Term Bases
Datenlecks bei Nutzung öffentlicher Cloud-Dienste ohne AV-Vertrag
Terminologie-Drift, wenn Translation Memories nicht regelmäßig aktualisiert werden
Fehlende Nachvollziehbarkeit ohne explizite Audit-Trail-Anforderungen im Vertrag
Gegenmaßnahmen: Datenverschlüsselung, EU-Hosting, explizite SLA-Klauseln zu Audit-Trails und Rückverfolgbarkeit sowie ein definierter Change-Control-Prozess für Terminologie-Updates.
Profi-Tipp: Starten Sie mit einem Pilotprojekt und definierten KPIs: Fehlerquote pro 1.000 Wörter, Zeit bis zur Veröffentlichung und Compliance-Findings im ersten internen Audit.
Welche Compliance-Anforderungen und Zertifikate müssen Sie prüfen?
Für regulierte Branchen ist die Compliance-Prüfung keine Formalität. Vier Prüffelder sind zwingend:
Datenhoheit: EU-Hosting, keine Verarbeitung auf öffentlichen Cloud-Servern außerhalb der EU, dokumentierter Auftragsverarbeitungsvertrag (AV-Vertrag) nach DSGVO
Zugriffskontrolle und Verschlüsselung: Rollenbasierte Zugriffsrechte, Verschlüsselung im Ruhezustand und bei der Übertragung
Zertifikate mit Audit-Nachweis: ISO 17100, ISO 18587, ISO 27001, ISO 13485, ISO 9001, ISO 42001 und AQAP2110 für Verteidigungsanwendungen. Verlangen Sie Zertifikate von unabhängigen Prüfstellen wie Bureau Veritas.
Audit-Trail: Versionskontrolle, Änderungsprotokolle mit Zeitstempel, Reviewer-Signaturen und definierte Archivierungsfristen
Für Life-Sciences-Unternehmen ist zusätzlich die Konformität mit der MDR zu prüfen; bei US-Marktbezug ist HIPAA-Relevanz zu klären. Ein Anbieter mit dokumentiertem SME-Netzwerk von über 3.500 Fachexperten und unabhängig auditierten ISO-Zertifikaten liefert hier die verlässlichste Grundlage.
Wie wählen Sie den richtigen Anbieter für Textautomatisierung?
Schlüsselfragen für die Ausschreibung:
Wo werden Daten gespeichert und verarbeitet? (EU-Hosting, AV-Vertrag vorhanden?)
Welche ISO-Zertifikate liegen vor, und wer hat sie auditiert?
Wie wird Terminologie-Durchsetzung technisch umgesetzt?
Wie groß ist das SME-Netzwerk, und welche Fachdomänen sind abgedeckt?
Welche SLA-Garantien gelten für Fehlerquoten und Reaktionszeiten?
Wie sieht die Exit-Strategie aus, und wie werden Daten zurückgegeben?
Eine einfache Scorecard hilft bei der Shortlist-Entscheidung:
Kriterium | Gewichtung | Prüfpunkte |
Compliance und Datenschutz | — | EU-Hosting, AV-Vertrag, ISO 27001, ISO 42001 |
Fachliche Genauigkeit | — | SME-Netzwerk, Terminologie-Durchsetzung, Testfall-Ergebnis |
Geschwindigkeit und Skalierbarkeit | — | Durchlaufzeiten, Sprachanzahl, Volumenkapazität |
Support und Auditierbarkeit | — | Audit-Trail, Reporting-Format, Eskalationspfad |
Fordern Sie immer einen Beispiel-Testfall mit Ihren eigenen Dokumenten an, bevor Sie einen Vertrag unterzeichnen.
Wann ist AD VERBUM die richtige Wahl?
Fit-Indikatoren:
Regulatorische Auditpflichten (MDR, DSGVO, HIPAA-Relevanz)
Hohe Terminologie-Sensitivität (IFU, klinische Berichte, Verträge, Regulatory Filings)
Bedarf an dokumentierter SME-Freigabe mit Änderungsnachweis
EU-Datenhoheit als nicht verhandelbare Anforderung
Typische Szenarien: Gebrauchsanweisungen für Medizinprodukte (Life Sciences), technische Dokumentation (MedTech), Vertragsübersetzungen (Legal), behördliche Einreichungen (Finance). Für diese Fälle bietet AD VERBUM spezialisierte Fachübersetzung mit 100 % AI+HUMAN hybrid translation, EU-Hosting, ISO-Zertifikaten und einem Netzwerk von 3.500+ Fachexperten.
Kein Fit: Rein informelle Massenkommunikation ohne Fachterminologie und ohne Auditbedarf, etwa interne Newsletter oder Social-Media-Posts ohne regulatorische Relevanz.
Wichtige Erkenntnisse
Für regulierte Inhalte ist ausschließlich ein AI+HUMAN hybrid translation-Workflow mit EU-Hosting, Terminologie-Governance und ISO-konformer QA audit-fähig.
Thema | Details |
Datenqualität zuerst | Strukturierte Eingangsdaten (PIM, CSV, API) bestimmen die Outputqualität; schlechte Daten liefern schlechte Texte. |
AI+HUMAN hybrid translation Pflicht | In regulierten Branchen ist SME-Review nach der KI-Generierung zwingend, nicht optional. |
EU-Hosting und Compliance | AV-Vertrag, ISO 27001 und EU-Hosting sind Mindestanforderungen; MDR und HIPAA-Relevanz separat prüfen. |
Anbieter-Scorecard nutzen | Compliance (—), Fachgenauigkeit (—), Geschwindigkeit (—), Auditierbarkeit (—) als Bewertungsrahmen. |
AD VERBUM als geprüfte Option | 3x bis 5x schnellere Durchlaufzeiten, 3.500+ Fachexperten, unabhängig auditierte ISO-Zertifikate, EU-Hosting. |
Warum kontrollierte Automatisierung der einzige realistische Weg ist
Wer Textautomatisierung in regulierten Umgebungen einführt, unterschätzt oft einen Punkt: Die Technologie ist nicht das Problem. Das Problem ist die Governance darum herum.
Ich habe erlebt, wie gut gemeinte Automatisierungsprojekte an einem einzigen Audit gescheitert sind, weil Reviewer-Signaturen fehlten oder Terminologie-Updates nicht rückverfolgbar waren. Das Tool hatte funktioniert. Der Prozess nicht. Automatisierung multipliziert die Wirkung von Fachexperten, aber sie ersetzt deren Urteil nicht. Ein Sprachmodell, das ohne SME-Review in die Produktion geht, ist kein Effizienzgewinn. Es ist ein unkontrolliertes Risiko.
Change Management ist dabei oft unterschätzt: Fachprüfer müssen verstehen, dass ihre Rolle sich verändert, nicht verschwindet. Wer das intern kommuniziert, bevor das erste Pilotprojekt startet, hat deutlich weniger Reibung.
AD VERBUM: Ihr Partner für regulierte Fachübersetzungen
Regulierte Branchen brauchen keinen generischen KI-Übersetzer. Sie brauchen einen Anbieter, der Terminologie-Governance, Datensouveränität und ISO-konforme QA in einem einzigen Workflow verbindet.
AD VERBUM liefert genau das: 100 % AI+HUMAN hybrid translation mit proprietärem LangOps-System auf EU-Servern, über 150 Sprachen, 3.500+ zertifizierte Fachexperten und unabhängig durch Bureau Veritas auditierte ISO-Zertifikate (ISO 17100, ISO 18587, ISO 27001, ISO 13485, ISO 42001, AQAP2110). Durchlaufzeiten verkürzen sich deutlich gegenüber klassischen Prozessen. Fordern Sie jetzt ein Pilotangebot an und prüfen Sie den Workflow an Ihren eigenen Dokumenten: Übersetzungsservices von AD VERBUM.
Empfohlene Quellen und Standards zur Vertiefung
Für die Vorbereitung von Ausschreibungen und internen Audits:
Textgenerierung (NLG) — Wikipedia: Technische Grundlagen und Klassifikation von Textgenerierungsansätzen
Automatische Texterstellung — Retresco: Praxisnahe Erklärung von NLG-Workflows und Template-Anforderungen
Textautomatisierung — mds.: Datenvorbereitung, Risiken und Qualitätssicherung in der Praxis
Text Automation — Vision11: Vergleich regelbasierter und LLM-basierter Ansätze
LLM vs. NMT für Fachübersetzungen: Technische Differenzierung mit Fokus auf regulierte Branchen
Sichere Übersetzungen erstellen: Operative Checkliste für audit-fähige Übersetzungsprozesse
Normative Referenzen für Ausschreibungen:
Standard | Anwendungsbereich |
ISO 17100 | Qualitätsanforderungen für Übersetzungsdienstleistungen |
ISO 18587 | Post-Editing maschineller Übersetzungsoutputs |
ISO 27001 | Informationssicherheits-Managementsysteme |
ISO 13485 | Qualitätsmanagementsysteme für Medizinprodukte |
ISO 42001 | KI-Managementsysteme und verantwortungsvoller KI-Einsatz |
AQAP 2110 | NATO-Qualitätssicherung für Verteidigungsanwendungen |
Dieser Artikel dient der allgemeinen Information. Für Ihre spezifische regulatorische Situation empfehlen wir die Rücksprache mit einem qualifizierten Compliance-Berater und den zuständigen Behörden.
Empfehlung


